# Tarea: hacer que mi web sea legible para los buscadores de IA
Actúa como un ingeniero especializado en SEO técnico y en GEO (optimización para motores generativos: ChatGPT Search, Claude, Perplexity, Google AI Overviews, Copilot).
## Contexto
- Web analizada: http://ciclosdelpuerto.example/
- Fecha del análisis: 24/9/2026
- Puntuación actual de visibilidad para IA: 38/100 (nota F)
- Paridad humano/IA: un visitante ve 181 palabras y un rastreador de IA recibe 0 (0%).
- Título actual: "Ciclos del Puerto"
- Datos estructurados presentes: ninguno
## Puntuación por bloques
- Acceso de las IAs: 83/100
- Contenido visible para la IA: 15/100
- Estructura y semántica: 35/100
- Datos estructurados: 14/100
- Contenido que responde: 5/100
- Técnico: 71/100
## Con quién compites
Ante la misma pregunta, una IA elige entre estas webs. Los números son de un análisis real hecho con los mismos criterios:
- tallerbicimalaga.example: 81/100, 612 palabras legibles
- ruedasdelsur.example: 58/100, 248 palabras legibles
- ciclosdelpuerto.example (mi web): 38/100, 0 palabras legibles
## Qué necesito que hagas
Resuelve los problemas de la lista siguiente **en el orden en que aparecen** (están ordenados por impacto real en si una IA puede citarme o no).
Para cada problema:
1. Localiza en mi proyecto el archivo o la plantilla donde se origina.
2. Aplica el cambio adaptándolo a mi stack real (no copies literalmente los ejemplos: úsalos como referencia).
3. Explícame en una frase qué has cambiado y por qué.
4. Dime cómo verificar que ha funcionado.
Si algo requiere una decisión de negocio (precios, textos comerciales, datos de contacto reales), no te lo inventes: pregúntame.
## Bloqueantes (sin esto, nada más importa)
### 1. La IA solo ve el 0% de tu web
**Gravedad:** Crítico
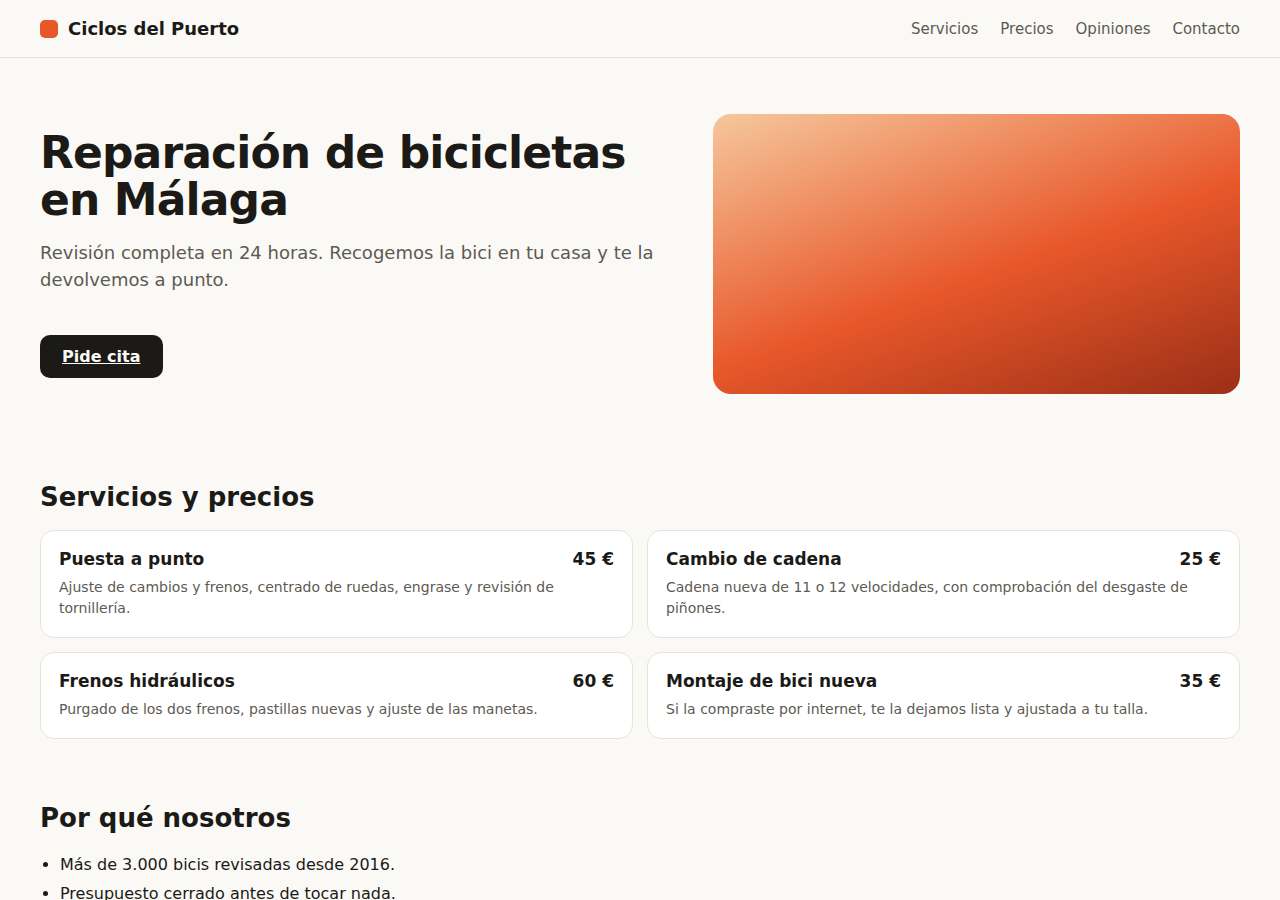
**Qué pasa:** Una persona lee 181 palabras en pantalla; un rastreador de IA recibe 0. La diferencia es contenido que se genera en el navegador.
**Por qué importa:** Cuando un modelo decide a quién citar, compara el contenido que ha podido leer. Si le falta la mitad de tu página, compites con la mitad de tus argumentos.
**Qué hay que hacer:**
Pasa a renderizado en servidor el contenido principal: textos, precios, fichas de producto, preguntas frecuentes y enlaces de navegación. Deja en el cliente solo lo interactivo (carritos, filtros, mapas).
### 2. Solo 0 palabras llegan a la IA
**Gravedad:** Crítico
**Qué pasa:** El HTML que devuelve el servidor contiene 0 palabras de texto real, frente a 181 que ve una persona en pantalla.
**Por qué importa:** Los modelos necesitan texto para extraer una respuesta y citarte. Con menos de 300 palabras difícilmente tienen material con el que responder a nada.
**Qué hay que hacer:**
Renderiza el contenido en el servidor (SSR/SSG) o pre-renderiza el HTML: la IA tiene que recibir el texto ya escrito en la respuesta, no un contenedor vacío.
### 3. Hay contenido que la IA nunca llega a leer
**Gravedad:** Crítico
**Qué pasa:** Estos textos se ven en pantalla pero no están en el HTML que recibe un rastreador:
• Reparación de bicicletas en Málaga
• Revisión completa en 24 horas.
• Recogemos la bici en tu casa y te la devolvemos a punto.
• Ajuste de cambios y frenos, centrado de ruedas, engrase y revisión de tornillería.
• Cadena nueva de 11 o 12 velocidades, con comprobación del desgaste de piñones.
• Purgado de los dos frenos, pastillas nuevas y ajuste de las manetas.
• Montaje de bici nueva
• Si la compraste por internet, te la dejamos lista y ajustada a tu talla.
**Por qué importa:** GPTBot, ClaudeBot y PerplexityBot leen el HTML tal cual llega. No esperan a que se ejecute tu JavaScript. Todo lo de arriba es, literalmente, invisible para ellos.
**Qué hay que hacer:**
Sirve ese contenido desde el servidor. Según tu stack:
• Next.js: usa Server Components o getStaticProps/generateStaticParams en lugar de useEffect + fetch.
• Nuxt: ssr: true y useAsyncData en vez de onMounted.
• React/Vue SPA puro: añade pre-renderizado (vite-plugin-prerender, react-snap) o migra a SSR.
• WordPress/CMS con widgets JS: sustituye el widget por HTML estático o añade el texto en el propio contenido.
Comprueba el resultado con: curl -s http://ciclosdelpuerto.example/ | grep -i "un trozo del texto"
<details><summary>Fragmento detectado en la web</summary>
```
Reparación de bicicletas en Málaga
---
Revisión completa en 24 horas.
---
Recogemos la bici en tu casa y te la devolvemos a punto.
---
Ajuste de cambios y frenos, centrado de ruedas, engrase y revisión de tornillería.
---
Cadena nueva de 11 o 12 velocidades, con comprobación del desgaste de piñones.
```
</details>
## Importantes
### 1. No hay encabezado H1
**Gravedad:** Grave
**Qué pasa:** El HTML crudo no contiene ningún <h1>.
**Por qué importa:** El H1 le dice al modelo cuál es el tema principal. Sin él (o con varios), la página pierde foco y el modelo no sabe qué está resumiendo.
**Qué hay que hacer:**
Añade un único <h1> con el tema principal de la página, escrito como lo diría un cliente.
### 2. La página no tiene encabezados
**Gravedad:** Grave
**Qué pasa:** No se ha encontrado ningún H1-H6 en el HTML servido.
**Por qué importa:** Los encabezados son los puntos de corte que usa un modelo para trocear la página en fragmentos citables. Sin ellos, tu contenido es un muro de texto y se cita entero o nada.
**Qué hay que hacer:**
Estructura el contenido con un H1 y varios H2/H3, cada uno formulado como la pregunta que responde esa sección.
### 3. No tienes datos estructurados
**Gravedad:** Grave
**Qué pasa:** El HTML no contiene ningún <script type="application/ld+json"> con schema.org.
**Por qué importa:** El JSON-LD es la ficha de identidad que un modelo lee sin ambigüedad: nombre, servicios, precios, horario, valoraciones. Sin él, la IA tiene que adivinar a partir del texto y se equivoca más (o te ignora y cita a quien sí se lo pone fácil).
**Qué hay que hacer:**
Añade en el <head> un bloque como este, ajustando los valores a tu negocio:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "TU MARCA",
  "url": "http://ciclosdelpuerto.example",
  "logo": "http://ciclosdelpuerto.example/logo.png",
  "description": "Qué haces, para quién y dónde, en una frase.",
  "sameAs": ["https://www.linkedin.com/company/…", "https://www.instagram.com/…"],
  "contactPoint": {
    "@type": "ContactPoint",
    "contactType": "customer service",
    "email": "hola@ciclosdelpuerto.example",
    "availableLanguage": ["es"]
  }
}
</script>
### 4. La web no usa HTTPS
**Gravedad:** Grave
**Qué pasa:** http://ciclosdelpuerto.example/ se sirve sin cifrado.
**Por qué importa:** Sin HTTPS pierdes posiciones en buscadores clásicos y varios rastreadores directamente descartan el dominio como fuente fiable.
**Qué hay que hacer:**
Instala un certificado TLS (Let's Encrypt es gratis), redirige todo el tráfico HTTP a HTTPS con un 301 y activa HSTS.
## Mejoras adicionales
### 1. No hay sitemap.xml
**Gravedad:** Medio
**Qué pasa:** No responde http://ciclosdelpuerto.example/sitemap.xml y robots.txt no declara ninguno.
**Por qué importa:** Sin sitemap, un rastreador solo encuentra lo que esté enlazado desde la portada. Las páginas profundas —justo las que responden preguntas concretas— se quedan sin indexar.
**Qué hay que hacer:**
Genera un sitemap.xml con todas tus URLs públicas y su <lastmod> real, publícalo en http://ciclosdelpuerto.example/sitemap.xml y decláralo en robots.txt con la línea:
Sitemap: http://ciclosdelpuerto.example/sitemap.xml
### 2. No hay contenido alternativo sin JavaScript
**Gravedad:** Medio
**Qué pasa:** La página depende de JS y no incluye un <noscript> con el contenido esencial.
**Por qué importa:** Mientras arreglas el renderizado en servidor, un <noscript> bien hecho da a la IA al menos el texto principal en vez de nada.
**Qué hay que hacer:**
Como parche temporal, incluye dentro de <noscript> el titular, los dos o tres párrafos clave y los enlaces principales. La solución definitiva sigue siendo servir el HTML ya renderizado.
### 3. Falta la meta description
**Gravedad:** Medio
**Qué pasa:** El HTML no incluye <meta name="description">.
**Por qué importa:** Muchos sistemas de IA usan la descripción como resumen de referencia de la página antes de leer el cuerpo.
**Qué hay que hacer:**
Añade una descripción de 140-160 caracteres que responda en una frase qué haces, para quién y dónde:
<meta name="description" content="…">
### 4. La página no usa HTML semántico
**Gravedad:** Medio
**Qué pasa:** No hay <main>, <article>, <nav> ni <header>: todo son <div>.
**Por qué importa:** Las etiquetas semánticas le dicen al extractor qué parte es el contenido y qué parte es menú o pie. Sin ellas, tu texto se mezcla con el de navegación y el modelo cita peor.
**Qué hay que hacer:**
Envuelve el contenido principal en <main>, cada pieza autónoma en <article>, el menú en <nav> y el pie en <footer>. Es sustituir divs por etiquetas con significado, sin tocar estilos.
### 5. No hay enlaces en el HTML servido
**Gravedad:** Medio
**Qué pasa:** El documento no contiene ningún <a href>.
**Por qué importa:** Si la navegación se genera con JavaScript, un rastreador de IA no encuentra el resto de tu web: solo indexa esta página suelta.
**Qué hay que hacer:**
Sirve el menú como enlaces <a href> reales en el HTML, no como botones con onClick.
### 6. La IA no sabe quién eres
**Gravedad:** Medio
**Qué pasa:** No hay ningún schema de tipo Organization, LocalBusiness ni Person.
**Por qué importa:** Las IAs recomiendan entidades, no URLs sueltas. Si no declaras nombre, ámbito y datos de contacto, no te asocian a tu sector ni a tu ciudad.
**Qué hay que hacer:**
Añade un bloque Organization (o LocalBusiness si atiendes a clientes en una dirección física) con name, url, logo, description, sameAs con tus perfiles sociales y, si aplica, address y areaServed.
### 7. Tus subtítulos no responden a las preguntas que hace la gente
**Gravedad:** Medio
**Qué pasa:** La página no tiene subtítulos H2/H3.
**Por qué importa:** Las IAs buscan el trozo de texto que responde literalmente a la pregunta del usuario. Un H2 que dice "Nuestros servicios" no casa con nada; "¿Cuánto cuesta reformar un baño en Valencia?" casa con una pregunta real.
**Qué hay que hacer:**
Reescribe al menos 3 subtítulos como la pregunta exacta que te haría un cliente, y responde en el primer párrafo debajo, en 2-3 frases. Ejemplo: "## ¿Cuánto tarda una reforma de baño?" seguido de "Entre 2 y 3 semanas en un baño estándar de 5 m²…".
### 8. Falta una respuesta directa en las primeras líneas
**Gravedad:** Medio
**Qué pasa:** La página empieza sin un párrafo que resuma de qué va.
**Por qué importa:** Un modelo suele citar los primeros 40-60 palabras que responden a la consulta. Si empiezas con relleno de marketing, se queda sin nada que extraer.
**Qué hay que hacer:**
Abre la página con un párrafo de 40-70 palabras que responda de forma literal: qué es, para quién, cuánto cuesta o cuánto tarda. Los adornos, después.
### 9. No tienes bloque de preguntas frecuentes
**Gravedad:** Medio
**Qué pasa:** No se ha detectado ninguna sección de preguntas frecuentes.
**Por qué importa:** Una FAQ marcada es el formato pregunta-respuesta que consumen directamente los motores de IA: cada par es una respuesta lista para servir con tu marca al lado.
**Qué hay que hacer:**
Añade 5-8 preguntas reales de clientes con su respuesta (2-4 frases cada una) y márcalas así:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "¿Cuánto cuesta el servicio?",
    "acceptedAnswer": {"@type": "Answer", "text": "Desde 300 € para un proyecto estándar…"}
  }]
}
</script>
Usa las preguntas que ya te llegan por email o WhatsApp: esas son las que la gente le escribe a la IA.
### 10. No tienes un archivo llms.txt
**Gravedad:** Menor
**Qué pasa:** http://ciclosdelpuerto.example/llms.txt no existe.
**Por qué importa:** llms.txt es un estándar emergente (aún no lo usan todos los motores) para decirle a un modelo qué páginas tuyas importan y en qué orden leerlas. Cuesta diez minutos y te posiciona para cuando se generalice.
**Qué hay que hacer:**
Crea http://ciclosdelpuerto.example/llms.txt en Markdown:
# ciclosdelpuerto.example

> Una frase describiendo qué hace tu negocio y a quién sirve.

## Páginas principales
- [Servicios](http://ciclosdelpuerto.example/servicios): qué ofreces exactamente.
- [Precios](http://ciclosdelpuerto.example/precios): tarifas y planes.
- [Contacto](http://ciclosdelpuerto.example/contacto): cómo contratarte.
### 11. Faltan metadatos Open Graph
**Gravedad:** Menor
**Qué pasa:** Falta: og:title, og:description, og:image.
**Por qué importa:** Varios asistentes usan Open Graph como resumen rápido cuando enseñan tu enlace dentro de una respuesta.
**Qué hay que hacer:**
Añade en el <head>:
<meta property="og:title" content="…">
<meta property="og:description" content="…">
<meta property="og:image" content="http://ciclosdelpuerto.example/portada.jpg">
<meta property="og:url" content="http://ciclosdelpuerto.example/">
<meta property="og:type" content="website">
### 12. Falta la tarjeta al compartir el enlace
**Gravedad:** Menor
**Qué pasa:** No se ha encontrado <meta name="twitter:card">.
**Por qué importa:** Cuando alguien pega tu enlace en X, Slack, WhatsApp o Discord, sin tarjeta aparece una línea de texto gris que nadie pulsa. Con imagen ocupa diez veces más y se comparte mucho más.
**Qué hay que hacer:**
Añade en el <head>:
<meta name="twitter:card" content="summary_large_image">
<meta name="twitter:title" content="…">
<meta name="twitter:description" content="…">
<meta name="twitter:image" content="http://ciclosdelpuerto.example/twitter-image.png">
La imagen debe medir 1200×630 px. Si usas Next.js puedes generarla desde el código con un archivo opengraph-image.tsx y otro twitter-image.tsx; así nunca se queda obsoleta.
### 13. Falta la URL canónica
**Gravedad:** Menor
**Qué pasa:** La página no declara <link rel="canonical">.
**Por qué importa:** Sin canónica, el mismo contenido servido en varias URLs (con y sin www, con parámetros, http y https) se cuenta como páginas distintas y tu autoridad se reparte entre todas.
**Qué hay que hacer:**
Añade en el <head>: <link rel="canonical" href="http://ciclosdelpuerto.example/">
### 14. Poco contenido en listas o tablas
**Gravedad:** Menor
**Qué pasa:** La página solo tiene 0 elementos de lista y 0 tablas.
**Por qué importa:** Las listas y las tablas son el formato que un modelo copia con más fidelidad, porque ya vienen troceadas en unidades comparables (precios, pasos, características).
**Qué hay que hacer:**
Convierte en listas los pasos de tu proceso y los elementos incluidos en cada servicio, y en tabla la comparativa de planes o precios. Es reformatear lo que ya tienes escrito.
### 15. El contenido no aporta datos concretos
**Gravedad:** Menor
**Qué pasa:** Solo se han detectado 0 cifras con unidad en toda la página.
**Por qué importa:** Las IAs prefieren citar afirmaciones verificables. "Somos líderes del sector" no se puede citar; "entregamos en 48 h y la instalación cuesta 149 €" sí, y arrastra tu marca con el dato.
**Qué hay que hacer:**
Añade cifras reales: precios desde, plazos de entrega, años de experiencia, número de proyectos, porcentajes de ahorro. Una cifra por sección.
### 16. El contenido parece desactualizado
**Gravedad:** Menor
**Qué pasa:** No hay fechas ni referencias al año actual.
**Por qué importa:** Ante dos fuentes que dicen lo mismo, los buscadores de IA citan la que demuestra ser reciente. Una página sin marcas temporales se asume vieja.
**Qué hay que hacer:**
Revisa y actualiza el contenido, muestra la fecha de última revisión en pantalla y actualiza "dateModified" en el JSON-LD. Si tus datos cambian poco, indica igualmente "Actualizado en 2026" donde sea cierto — nunca lo pongas si no lo has revisado. Página analizada: /
### 17. El HTML se envía sin comprimir
**Gravedad:** Menor
**Qué pasa:** La respuesta no incluye la cabecera Content-Encoding.
**Por qué importa:** Comprimir reduce el HTML un 70-80 %. Menos bytes es menos tiempo de descarga por página, y más páginas tuyas rastreadas con el mismo presupuesto.
**Qué hay que hacer:**
Activa gzip o brotli en tu servidor (Nginx: gzip on; Apache: mod_deflate) o ponte detrás de una CDN que lo haga por ti.
## Contenido que hoy la IA no puede leer
Estos textos se ven en el navegador pero NO están en el HTML que devuelve el servidor. Asegúrate de que, al terminar, todos aparezcan en el HTML inicial:
- "Reparación de bicicletas en Málaga"
- "Revisión completa en 24 horas."
- "Recogemos la bici en tu casa y te la devolvemos a punto."
- "Ajuste de cambios y frenos, centrado de ruedas, engrase y revisión de tornillería."
- "Cadena nueva de 11 o 12 velocidades, con comprobación del desgaste de piñones."
- "Purgado de los dos frenos, pastillas nuevas y ajuste de las manetas."
- "Montaje de bici nueva"
- "Si la compraste por internet, te la dejamos lista y ajustada a tu talla."
- "Más de 3.000 bicis revisadas desde 2016."
- "Presupuesto cerrado antes de tocar nada."
## Cómo hacer la imagen que se ve al compartir el enlace
Tu enlace necesita una imagen de 1200×630 px para Open Graph (Facebook, LinkedIn, WhatsApp, Slack) y otra para Twitter Card (X). Pueden ser el mismo archivo.
**Si el proyecto usa Next.js (App Router), genéralas desde el código** para que no se queden nunca obsoletas. Crea `app/opengraph-image.tsx`:
```tsx
import { ImageResponse } from "next/og";
export const alt = "Ciclos del Puerto";
export const size = { width: 1200, height: 630 };
export const contentType = "image/png";
export default function Image() {
return new ImageResponse(
(
<div
style={{
width: "100%",
height: "100%",
display: "flex",
flexDirection: "column",
justifyContent: "center",
padding: "80px",
// Un degradado en diagonal da profundidad sin necesitar imágenes.
background: "linear-gradient(135deg, #0b1020 0%, #1b1038 60%, #2a1458 100%)",
color: "#ffffff",
fontFamily: "sans-serif",
}}
>
<div style={{ fontSize: 26, opacity: 0.75 }}>ciclosdelpuerto.example</div>
<div style={{ marginTop: 32, fontSize: 64, fontWeight: 700, lineHeight: 1.08, letterSpacing: -2 }}>
TU AFIRMACIÓN PRINCIPAL, LA MISMA QUE EL H1
</div>
<div style={{ marginTop: 34, fontSize: 28, color: "#c4b5fd", maxWidth: 940 }}>
Una línea de apoyo: qué ofreces y para quién.
</div>
</div>
),
size,
);
}
```
Después crea `app/twitter-image.tsx` reexportando lo mismo, para que las dos tarjetas coincidan:
```tsx
export { default, alt, size, contentType } from "../opengraph-image";
```
Next emite entonces las etiquetas `og:image` y `twitter:image` solo. Define `metadataBase: new URL("https://TU-DOMINIO")` en el layout raíz para que las URLs salgan absolutas: las relativas las ignoran casi todos los rastreadores.
**Si el proyecto no usa Next.js**, exporta un PNG de 1200×630 de menos de 1 MB, ponlo en `/og-image.png` y declara las etiquetas a mano:
```html
<meta property="og:title" content="…">
<meta property="og:description" content="…">
<meta property="og:image" content="https://TU-DOMINIO/og-image.png">
<meta property="og:image:width" content="1200">
<meta property="og:image:height" content="630">
<meta property="og:url" content="https://TU-DOMINIO/">
<meta property="og:type" content="website">
<meta name="twitter:card" content="summary_large_image">
<meta name="twitter:title" content="…">
<meta name="twitter:description" content="…">
<meta name="twitter:image" content="https://TU-DOMINIO/og-image.png">
```
Las reglas que marcan la diferencia:
- Exactamente 1200×630 px. Otras proporciones se recortan y el texto se pierde.
- Legible en miniatura: la frase a 60 px o más, tres líneas como máximo.
- La imagen repite la promesa de la página. No es un logo sobre un fondo.
- URLs absolutas y con protocolo. Una ruta relativa falla sin avisar.
- Menos de 1 MB, en PNG o JPEG. WebP todavía no lo leen todos los rastreadores.
- Compruébalo en https://cards-dev.twitter.com/validator y pegando el enlace en un chat de Slack o WhatsApp contigo mismo.
## Cómo comprobar que está arreglado
Cuando termines, ejecuta estas comprobaciones y enséñame el resultado:
```bash
# 1. Esto es LITERALMENTE lo que ve un rastreador de IA (sin ejecutar JavaScript).
curl -sL "http://ciclosdelpuerto.example/" | sed 's/<script[^>]*>.*<\/script>//g; s/<[^>]*>//g' | tr -s ' \n' | head -60
# 2. El servidor no debe bloquear a los bots de IA (espera un 200 en todos).
curl -sL -o /dev/null -w "OAI-SearchBot: %{http_code}\n" -A "OAI-SearchBot" "http://ciclosdelpuerto.example/"
curl -sL -o /dev/null -w "Claude-SearchBot: %{http_code}\n" -A "Claude-SearchBot" "http://ciclosdelpuerto.example/"
curl -sL -o /dev/null -w "PerplexityBot: %{http_code}\n" -A "PerplexityBot" "http://ciclosdelpuerto.example/"
# 3. robots.txt no debe tener un Disallow que afecte a esos agentes.
curl -s "http://ciclosdelpuerto.example/robots.txt"
```
El objetivo es que el texto del punto 1 contenga todo el contenido importante de la página. Si ahí no aparece, para la IA no existe.
---
Informe generado por AI visibility analyzer · http://ciclosdelpuerto.example/ · 38/100