> Répondez en français et rédigez aussi en français les commentaires du code.
# Tâche : rendre mon site lisible par les moteurs de recherche IA
Agissez en ingénieur spécialisé en SEO technique et en GEO (optimisation pour les moteurs génératifs : ChatGPT Search, Claude, Perplexity, Google AI Overviews, Copilot).
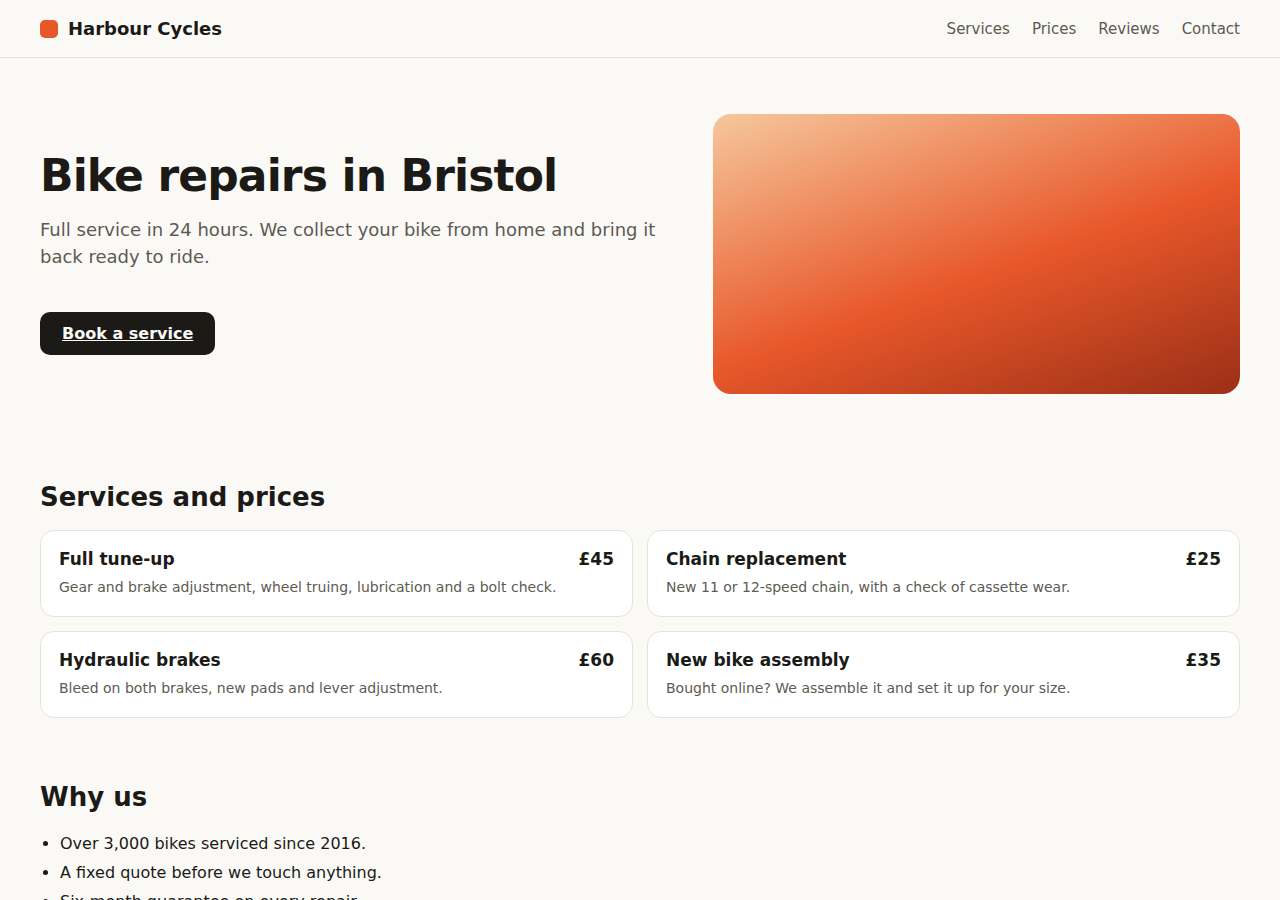
## Contexte
- Site analysé : http://harborcyclery.example/
- Date de l’analyse : 24/09/2026
- Note actuelle de visibilité IA : 36/100 (note F)
- Parité humain/IA : un visiteur voit 160 mots et un robot d’IA en reçoit 0 (0 %).
- Titre actuel : "Harbor Cyclery"
- Données structurées présentes : aucune
## Note par domaine
- Accès des robots d’IA : 83/100
- Contenu visible pour l’IA : 15/100
- Structure et sémantique : 25/100
- Données structurées : 14/100
- Contenu qui répond aux questions : 5/100
- Technique : 71/100
## Mes concurrents
Face à la même question, une IA choisit parmi ces sites. Les chiffres viennent d’une analyse réelle, menée selon les mêmes critères :
- bristolbikeworks.example : 79/100, 588 mots lisibles
- quaysidecycles.example : 55/100, 231 mots lisibles
- harborcyclery.example (mon site) : 36/100, 0 mots lisibles
## Ce que j’attends de vous
Corrigez les problèmes listés ci-dessous **dans l’ordre où ils apparaissent** (ils sont classés selon leur effet réel sur la possibilité qu’une IA me cite).
Pour chaque problème :
1. Trouvez dans mon projet le fichier ou le template d’où il vient.
2. Appliquez la modification en l’adaptant à ma stack réelle (ne recopiez pas les exemples tels quels : servez-vous-en comme référence).
3. Expliquez-moi en une phrase ce que vous avez changé et pourquoi.
4. Dites-moi comment vérifier que ça a fonctionné.
Travaillez par étapes, pas tout d’un coup : d’abord les points bloquants. À la fin de chaque étape, résumez ce que vous avez modifié et le résultat des vérifications, puis attendez ma confirmation avant de passer à la suivante.
Je n’ai pas pu détecter la technologie du site depuis l’extérieur. Avant de modifier quoi que ce soit, vérifiez-la dans le projet (package.json, fichiers de configuration) et indiquez-la-moi ; si vous n’avez pas accès au code, demandez-la-moi et attendez ma réponse.
Attention : le HTML servi par le site est presque vide, et beaucoup de points de la liste (H1, titres, liens, HTML sémantique, balises meta) peuvent en découler. Une fois le contenu rendu côté serveur, revérifiez le HTML servi et ne corrigez que ce qui échoue encore. Si la liste contient le correctif <noscript>, ignorez-le : avec le HTML rendu, il n’est plus utile.
Si quelque chose demande une décision commerciale (prix, textes de vente, vraies coordonnées), n’inventez rien : posez-moi la question.
## Bloquants (tant qu’ils ne sont pas corrigés, le reste ne compte pas)
### 1. L’IA ne voit que 0 % de votre site
**Gravité :** Critique
**Ce qui se passe :** Une personne lit 160 mots à l’écran ; un robot d’IA en reçoit 0. La différence, c’est du contenu généré dans le navigateur.
**Pourquoi c’est important :** Quand un modèle décide qui citer, il compare le contenu qu’il a réussi à lire. S’il manque la moitié de votre page, vous vous battez avec la moitié de vos arguments.
**Ce qu’il faut faire :**
Passez le contenu principal en rendu côté serveur : textes, prix, fiches produit, FAQ et liens de navigation. Ne laissez côté client que ce qui est interactif (paniers, filtres, cartes).
### 2. Seulement 0 mot arrive jusqu’à l’IA
**Gravité :** Critique
**Ce qui se passe :** Le HTML renvoyé par le serveur contient 0 mot de vrai texte, contre les 160 qu’une personne voit à l’écran.
**Pourquoi c’est important :** Les modèles ont besoin de texte pour en extraire une réponse et vous citer. Avec moins de 300 mots, ils n’ont pas grand-chose à se mettre sous la dent.
**Ce qu’il faut faire :**
Rendez le contenu côté serveur (SSR/SSG) ou pré-rendez le HTML : l’IA doit recevoir le texte déjà écrit dans la réponse, pas un conteneur vide.
### 3. Une partie du contenu n’arrive jamais à l’IA
**Gravité :** Critique
**Ce qui se passe :** Ces textes s’affichent à l’écran mais ne figurent pas dans le HTML que reçoit un robot :
• Bike repair in Portland
• Full service in 24 hours.
• We collect your bike from home and bring it back ready to ride.
• Gear and brake adjustment, wheel truing, lubrication and a bolt check.
• New 11 or 12-speed chain, with a check of cassette wear.
• Bleed on both brakes, new pads and lever adjustment.
• We assemble it and set it up for your size.
• Over 3,000 bikes serviced since 2016.
**Pourquoi c’est important :** GPTBot, ClaudeBot et PerplexityBot lisent le HTML tel qu’il arrive. Ils n’attendent pas que votre JavaScript s’exécute. Tout ce qui précède leur est littéralement invisible.
**Ce qu’il faut faire :**
Servez ce contenu depuis le serveur. Selon votre stack :
• Next.js : utilisez des Server Components ou getStaticProps/generateStaticParams au lieu de useEffect + fetch.
• Nuxt : ssr: true et useAsyncData au lieu de onMounted.
• SPA React/Vue classique : ajoutez un pré-rendu (vite-plugin-prerender, react-snap) ou passez au SSR.
• CMS avec widgets JS : remplacez le widget par du HTML statique ou mettez le texte dans le contenu lui-même.
Vérifiez le résultat avec : curl -s http://harborcyclery.example/ | grep -i "un bout de votre texte"
<details><summary>Extrait détecté sur le site</summary>
```
Bike repair in Portland
---
Full service in 24 hours.
---
We collect your bike from home and bring it back ready to ride.
---
Gear and brake adjustment, wheel truing, lubrication and a bolt check.
---
New 11 or 12-speed chain, with a check of cassette wear.
```
</details>
## Importants
### 1. Aucun titre H1
**Gravité :** Élevée
**Ce qui se passe :** Le HTML brut ne contient aucun <h1>.
**Pourquoi c’est important :** Le H1 indique au modèle le sujet principal. Sans lui (ou avec plusieurs), la page perd son fil et le modèle ne sait pas ce qu’il est en train de résumer.
**Ce qu’il faut faire :**
Ajoutez un seul <h1> avec le sujet principal de la page, formulé comme le dirait un client.
### 2. La page n’a aucun titre de section
**Gravité :** Élevée
**Ce qui se passe :** Aucune balise H1 à H6 dans le HTML servi.
**Pourquoi c’est important :** Les titres sont les points de coupe qu’un modèle utilise pour découper la page en fragments citables. Sans eux, votre contenu forme un bloc compact, cité en entier ou pas du tout.
**Ce qu’il faut faire :**
Structurez le contenu avec un H1 et plusieurs H2/H3, chacun formulé comme la question à laquelle répond la section.
### 3. Vous n’avez aucune donnée structurée
**Gravité :** Élevée
**Ce qui se passe :** Le HTML ne contient aucun <script type="application/ld+json"> avec schema.org.
**Pourquoi c’est important :** Le JSON-LD est la carte d’identité qu’un modèle lit sans ambiguïté : nom, services, prix, horaires, avis. Sans lui, l’IA doit deviner à partir du texte, se trompe plus souvent, ou vous ignore et cite celui qui lui a mâché le travail.
**Ce qu’il faut faire :**
Ajoutez un bloc comme celui-ci dans le <head>, en adaptant les valeurs à votre activité :
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "VOTRE MARQUE",
  "url": "http://harborcyclery.example",
  "logo": "http://harborcyclery.example/logo.png",
  "description": "Ce que vous faites, pour qui et où, en une phrase.",
  "sameAs": ["https://www.linkedin.com/company/…", "https://www.instagram.com/…"],
  "contactPoint": {
    "@type": "ContactPoint",
    "contactType": "customer service",
    "email": "hello@harborcyclery.example",
    "availableLanguage": ["en"]
  }
}
</script>
### 4. Le site n’utilise pas HTTPS
**Gravité :** Élevée
**Ce qui se passe :** http://harborcyclery.example/ est servi sans chiffrement.
**Pourquoi c’est important :** Sans HTTPS, vous perdez des positions dans les moteurs de recherche classiques, et plusieurs robots écartent d’emblée le domaine comme source fiable.
**Ce qu’il faut faire :**
Installez un certificat TLS (Let's Encrypt est gratuit), redirigez tout le trafic HTTP vers HTTPS avec une 301 et activez HSTS.
## Améliorations complémentaires
### 1. Pas de sitemap.xml
**Gravité :** Moyenne
**Ce qui se passe :** http://harborcyclery.example/sitemap.xml ne répond pas et robots.txt n’en déclare aucun.
**Pourquoi c’est important :** Sans sitemap, un robot ne trouve que ce qui est lié depuis la page d’accueil. Les pages profondes, justement celles qui répondent à des questions précises, ne sont jamais indexées.
**Ce qu’il faut faire :**
Générez un sitemap.xml avec chaque URL publique et sa vraie date <lastmod>, publiez-le sur http://harborcyclery.example/sitemap.xml et déclarez-le dans robots.txt avec la ligne :
Sitemap: http://harborcyclery.example/sitemap.xml
### 2. Aucun contenu de secours sans JavaScript
**Gravité :** Moyenne
**Ce qui se passe :** La page dépend de JS et n’a pas de <noscript> avec le contenu essentiel.
**Pourquoi c’est important :** Le temps de corriger le rendu côté serveur, un vrai <noscript> donne au moins à l’IA le texte principal au lieu de rien.
**Ce qu’il faut faire :**
Comme rustine temporaire, placez le titre, les deux ou trois paragraphes clés et les liens principaux dans <noscript>. La vraie correction reste de servir du HTML rendu.
### 3. Le titre n’est pas optimisé
**Gravité :** Moyenne
**Ce qui se passe :** Le <title> fait 14 caractères : « Harbor Cyclery ».
**Pourquoi c’est important :** Le titre est le premier signal qu’un modèle lit pour savoir de quoi parle la page et si elle répond à la question de l’utilisateur.
**Ce qu’il faut faire :**
Rédigez un titre de 50 à 60 caractères sur le modèle « Ce que vous proposez | Marque », avec les mots que votre client taperait en interrogeant une IA.
<details><summary>Extrait détecté sur le site</summary>
```
Harbor Cyclery
```
</details>
### 4. Meta description manquante
**Gravité :** Moyenne
**Ce qui se passe :** Le HTML n’a pas de <meta name="description">.
**Pourquoi c’est important :** Beaucoup de systèmes d’IA utilisent la description comme résumé de référence de la page, avant même de lire le corps du texte.
**Ce qu’il faut faire :**
Ajoutez une description de 140 à 160 caractères qui dit en une phrase ce que vous faites, pour qui et où :
<meta name="description" content="…">
### 5. La page n’utilise pas de HTML sémantique
**Gravité :** Moyenne
**Ce qui se passe :** Il n’y a ni <main>, ni <article>, ni <nav>, ni <header> : tout est en <div>.
**Pourquoi c’est important :** Les balises sémantiques indiquent à l’extracteur quelle partie est du contenu et laquelle est un menu ou un pied de page. Sans elles, votre texte se mélange à la navigation et le modèle vous cite moins bien.
**Ce qu’il faut faire :**
Enveloppez le contenu principal dans <main>, chaque bloc autonome dans <article>, le menu dans <nav> et le pied de page dans <footer>. Il s’agit de remplacer des div par des balises qui ont un sens, sans toucher aux styles.
### 6. Aucun lien dans le HTML servi
**Gravité :** Moyenne
**Ce qui se passe :** Le document ne contient aucun <a href>.
**Pourquoi c’est important :** Si la navigation est générée en JavaScript, un robot d’IA ne peut pas trouver le reste de votre site : il n’indexe que cette page isolée.
**Ce qu’il faut faire :**
Servez le menu sous forme de vrais liens <a href> dans le HTML, pas de boutons avec onClick.
### 7. L’IA ne sait pas qui vous êtes
**Gravité :** Moyenne
**Ce qui se passe :** Il n’y a aucun schéma de type Organization, LocalBusiness ou Person.
**Pourquoi c’est important :** Les IA recommandent des entités, pas des URL isolées. Si vous ne déclarez pas votre nom, votre champ d’activité et vos coordonnées, elles ne vous associent ni à votre secteur ni à votre ville.
**Ce qu’il faut faire :**
Ajoutez un bloc Organization (ou LocalBusiness si vous recevez vos clients à une adresse physique) avec name, url, logo, description, sameAs avec vos profils sur les réseaux sociaux et, le cas échéant, address et areaServed.
### 8. Vos sous-titres ne répondent pas aux questions que les gens posent
**Gravité :** Moyenne
**Ce qui se passe :** La page n’a aucun sous-titre H2/H3.
**Pourquoi c’est important :** Les IA cherchent le passage qui répond littéralement à la question de l’utilisateur. Un H2 « Nos services » ne correspond à rien ; « Combien coûte la rénovation d’une salle de bains à Lyon ? » correspond à une vraie question.
**Ce qu’il faut faire :**
Réécrivez au moins 3 sous-titres sous la forme exacte de la question que poserait un client, et répondez dans le premier paragraphe qui suit, en 2 ou 3 phrases. Exemple : « ## Combien de temps dure la rénovation d’une salle de bains ? » suivi de « Deux à trois semaines pour une salle de bains standard de 5 m²… ».
### 9. Pas de réponse directe dans les premières lignes
**Gravité :** Moyenne
**Ce qui se passe :** La page commence sans paragraphe qui résume son sujet.
**Pourquoi c’est important :** Un modèle cite en général les 40 à 60 premiers mots qui répondent à la requête. Si vous ouvrez sur du remplissage marketing, il n’a rien à extraire.
**Ce qu’il faut faire :**
Ouvrez la page avec un paragraphe de 40 à 70 mots qui répond littéralement : ce que c’est, pour qui, combien ça coûte ou combien de temps ça prend. Gardez les effets de style pour plus tard.
### 10. Pas de bloc de questions fréquentes
**Gravité :** Moyenne
**Ce qui se passe :** Aucune section de questions fréquentes détectée.
**Pourquoi c’est important :** Une FAQ balisée est le format question-réponse que les moteurs IA consomment directement : chaque paire est une réponse prête à servir, avec votre marque à côté.
**Ce qu’il faut faire :**
Ajoutez 5 à 8 vraies questions de clients avec leurs réponses (2 à 4 phrases chacune) et balisez-les ainsi :
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "Combien coûte le service ?",
    "acceptedAnswer": {"@type": "Answer", "text": "À partir de 300 € pour un projet standard…"}
  }]
}
</script>
Partez des questions que vous recevez déjà par e-mail ou sur WhatsApp : ce sont celles que les gens tapent dans une IA.
### 11. Pas de fichier llms.txt
**Gravité :** Faible
**Ce qui se passe :** http://harborcyclery.example/llms.txt n’existe pas.
**Pourquoi c’est important :** llms.txt est un standard émergent (tous les moteurs ne l’utilisent pas encore) pour indiquer à un modèle quelles pages comptent et dans quel ordre les lire. Cela prend dix minutes et vous place en bonne position pour le jour où il se généralisera.
**Ce qu’il faut faire :**
Créez http://harborcyclery.example/llms.txt en Markdown :
# harborcyclery.example

> Une phrase qui décrit ce que fait votre entreprise et pour qui.

## Pages principales
- [Services](http://harborcyclery.example/services): ce que vous proposez, précisément.
- [Tarifs](http://harborcyclery.example/pricing): prix et formules.
- [Contact](http://harborcyclery.example/contact): comment faire appel à vous.
### 12. Métadonnées Open Graph manquantes
**Gravité :** Faible
**Ce qui se passe :** Il manque : og:title, og:description, og:image.
**Pourquoi c’est important :** Plusieurs assistants utilisent Open Graph comme résumé rapide quand ils affichent votre lien dans une réponse.
**Ce qu’il faut faire :**
Ajoutez dans le <head> :
<meta property="og:title" content="…">
<meta property="og:description" content="…">
<meta property="og:image" content="http://harborcyclery.example/cover.jpg">
<meta property="og:url" content="http://harborcyclery.example/">
<meta property="og:type" content="website">
### 13. Il manque la carte d’aperçu de vos liens
**Gravité :** Faible
**Ce qui se passe :** Aucune balise <meta name="twitter:card"> trouvée.
**Pourquoi c’est important :** Quand quelqu’un colle votre lien dans X, Slack, WhatsApp ou Discord, un lien sans carte s’affiche comme une ligne de texte gris sur laquelle personne ne clique. Avec une image, il prend dix fois plus de place et se partage beaucoup plus.
**Ce qu’il faut faire :**
Ajoutez dans le <head> :
<meta name="twitter:card" content="summary_large_image">
<meta name="twitter:title" content="…">
<meta name="twitter:description" content="…">
<meta name="twitter:image" content="http://harborcyclery.example/twitter-image.png">
L’image doit mesurer 1200×630 px. Sur Next.js, vous pouvez la générer depuis le code avec un fichier opengraph-image.tsx et un fichier twitter-image.tsx : ainsi, elle n’est jamais périmée.
### 14. URL canonique manquante
**Gravité :** Faible
**Ce qui se passe :** La page ne déclare pas de <link rel="canonical">.
**Pourquoi c’est important :** Sans URL canonique, un même contenu servi à plusieurs adresses (avec et sans www, avec des paramètres, en http et en https) compte comme autant de pages différentes, et votre autorité se répartit entre elles.
**Ce qu’il faut faire :**
Ajoutez dans le <head> : <link rel="canonical" href="http://harborcyclery.example/">
### 15. Peu de contenu en listes ou en tableaux
**Gravité :** Faible
**Ce qui se passe :** La page ne compte que 0 élément de liste et 0 tableau.
**Pourquoi c’est important :** Les listes et les tableaux sont le format qu’un modèle recopie le plus fidèlement, parce qu’ils arrivent déjà découpés en unités comparables (prix, étapes, caractéristiques).
**Ce qu’il faut faire :**
Transformez les étapes de votre processus et le contenu de chaque service en listes, et la comparaison de vos formules ou de vos prix en tableau. Il s’agit de remettre en forme ce que vous avez déjà écrit.
### 16. Le contenu ne donne aucun chiffre concret
**Gravité :** Faible
**Ce qui se passe :** Seulement 0 chiffre avec unité trouvé sur toute la page.
**Pourquoi c’est important :** Les IA préfèrent citer des affirmations vérifiables. « Nous sommes leaders du secteur » ne se cite pas ; « nous livrons en 48 heures et l’installation coûte 149 € » se cite, et entraîne votre marque avec le chiffre.
**Ce qu’il faut faire :**
Ajoutez des chiffres réels : prix de départ, délais, années d’activité, projets réalisés, pourcentage d’économies. Un chiffre par section.
### 17. Le contenu semble daté
**Gravité :** Faible
**Ce qui se passe :** Il n’y a aucune date ni référence à l’année en cours.
**Pourquoi c’est important :** Entre deux sources qui disent la même chose, les moteurs de recherche IA citent celle qui prouve qu’elle est récente. Une page sans repère dans le temps est présumée ancienne.
**Ce qu’il faut faire :**
Relisez et mettez à jour le contenu, affichez à l’écran la date de dernière révision et mettez à jour « dateModified » dans le JSON-LD. Si vos données changent rarement, indiquez quand même « Mis à jour en 2026 » là où c’est vrai, mais jamais si vous n’avez pas relu la page. Page analysée : /
### 18. Le HTML est envoyé sans compression
**Gravité :** Faible
**Ce qui se passe :** La réponse n’a pas d’en-tête Content-Encoding.
**Pourquoi c’est important :** La compression réduit le HTML de 70 à 80 %. Moins d’octets, c’est moins de temps de téléchargement par page, et davantage de pages explorées avec le même budget.
**Ce qu’il faut faire :**
Activez gzip ou brotli sur votre serveur (gzip on; dans Nginx, mod_deflate dans Apache) ou placez-vous derrière un CDN qui s’en charge.
## Contenu que l’IA ne peut pas lire aujourd’hui
Ces textes s’affichent dans le navigateur mais ne figurent PAS dans le HTML renvoyé par le serveur. Une fois votre travail terminé, ils doivent tous apparaître dans le HTML initial :
- "Bike repair in Portland"
- "Full service in 24 hours."
- "We collect your bike from home and bring it back ready to ride."
- "Gear and brake adjustment, wheel truing, lubrication and a bolt check."
- "New 11 or 12-speed chain, with a check of cassette wear."
- "Bleed on both brakes, new pads and lever adjustment."
- "We assemble it and set it up for your size."
- "Over 3,000 bikes serviced since 2016."
- "A fixed quote before we touch anything."
- "Six-month guarantee on every repair."
## Comment créer l’image affichée quand le lien est partagé
Votre lien a besoin d'une image de 1200×630 px pour Open Graph (Facebook, LinkedIn, WhatsApp, Slack) et d'une autre pour Twitter Card (X). Ce peut être le même fichier.
**Si le projet utilise Next.js (App Router), générez-les depuis le code**, pour qu'elles ne deviennent jamais obsolètes. Créez `app/opengraph-image.tsx` :
```tsx
import { ImageResponse } from "next/og";
export const alt = "Harbor Cyclery";
export const size = { width: 1200, height: 630 };
export const contentType = "image/png";
export default function Image() {
return new ImageResponse(
(
<div
style={{
width: "100%",
height: "100%",
display: "flex",
flexDirection: "column",
justifyContent: "center",
padding: "80px",
// Un dégradé en diagonale donne de la profondeur sans avoir besoin d'images.
background: "linear-gradient(135deg, #0b1020 0%, #1b1038 60%, #2a1458 100%)",
color: "#ffffff",
fontFamily: "sans-serif",
}}
>
<div style={{ fontSize: 26, opacity: 0.75 }}>harborcyclery.example</div>
<div style={{ marginTop: 32, fontSize: 64, fontWeight: 700, lineHeight: 1.08, letterSpacing: -2 }}>
VOTRE MESSAGE PRINCIPAL, LE MÊME QUE LE H1
</div>
<div style={{ marginTop: 34, fontSize: 28, color: "#c4b5fd", maxWidth: 940 }}>
Une ligne complémentaire : ce que vous proposez et pour qui.
</div>
</div>
),
size,
);
}
```
Créez ensuite `app/twitter-image.tsx`, qui réexporte la même chose, pour que les deux cartes soient identiques :
```tsx
export { default, alt, size, contentType } from "../opengraph-image";
```
Next génère alors tout seul les balises `og:image` et `twitter:image`. Définissez `metadataBase: new URL("https://VOTRE-DOMAINE")` dans le layout racine pour que les URL soient absolues : la plupart des robots ignorent les URL relatives.
**Si le projet n'utilise pas Next.js**, exportez un PNG de 1200×630 de moins de 1 Mo, placez-le dans `/og-image.png` et déclarez les balises à la main :
```html
<meta property="og:title" content="…">
<meta property="og:description" content="…">
<meta property="og:image" content="https://VOTRE-DOMAINE/og-image.png">
<meta property="og:image:width" content="1200">
<meta property="og:image:height" content="630">
<meta property="og:url" content="https://VOTRE-DOMAINE/">
<meta property="og:type" content="website">
<meta name="twitter:card" content="summary_large_image">
<meta name="twitter:title" content="…">
<meta name="twitter:description" content="…">
<meta name="twitter:image" content="https://VOTRE-DOMAINE/og-image.png">
```
Les règles qui font la différence :
- Exactement 1200×630 px. Les autres formats sont recadrés et le texte se perd.
- Lisible en miniature : le message à 60 px ou plus, trois lignes au maximum.
- L'image reprend la promesse de la page. Ce n'est pas un logo posé sur un fond.
- Des URL absolues, avec le protocole. Un chemin relatif échoue sans prévenir.
- Moins de 1 Mo, en PNG ou en JPEG. Tous les robots ne lisent pas encore le WebP.
- Vérifiez-la sur https://cards-dev.twitter.com/validator et en collant le lien dans une conversation Slack ou WhatsApp avec vous-même.
## Comment vérifier que c’est corrigé
Quand vous aurez terminé, lancez ces vérifications et montrez-moi le résultat :
```bash
# 1. Voici LITTÉRALEMENT ce que voit un robot d’IA (sans exécuter JavaScript).
curl -sL "http://harborcyclery.example/" | sed 's/<script[^>]*>.*<\/script>//g; s/<[^>]*>//g' | tr -s ' \n' | head -60
# 2. Le serveur ne doit pas bloquer les robots d’IA (chacun doit renvoyer 200).
curl -sL -o /dev/null -w "OAI-SearchBot: %{http_code}\n" -A "OAI-SearchBot" "http://harborcyclery.example/"
curl -sL -o /dev/null -w "Claude-SearchBot: %{http_code}\n" -A "Claude-SearchBot" "http://harborcyclery.example/"
curl -sL -o /dev/null -w "PerplexityBot: %{http_code}\n" -A "PerplexityBot" "http://harborcyclery.example/"
# 3. robots.txt ne doit contenir aucun Disallow qui concerne ces agents.
curl -s "http://harborcyclery.example/robots.txt"
```
L’objectif : que le texte de l’étape 1 contienne tout le contenu important de la page. S’il n’y figure pas, pour l’IA, il n’existe pas.
---
Rapport généré par Tarsier · http://harborcyclery.example/ · 36/100